
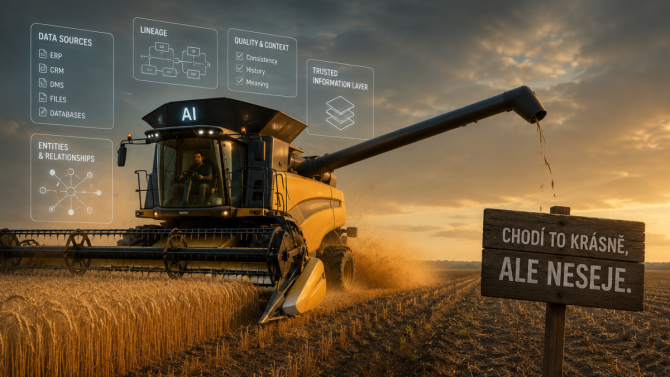
Pak přijde produkce.
A ukáže se scéna z filmu Marečku, podejte mi pero!: secí stroj chodí krásně, ale neseje. Aplikace funguje, model funguje, jen výsledky nejsou dost spolehlivé na to, aby podle nich bylo možné rozhodovat.
Důvod bývá méně sexy než samotná AI.
Data.
Ne nutně špatná. Prostě firemní. Rozdělená mezi systémy, v různých formátech, s různými identifikátory a různou historií. Jeden zákazník existuje třikrát, protože se přejmenoval. Smlouva má několik verzí. Stejná hodnota má v různých systémech jiný význam. Informace, která byla před pěti lety aktuální, dnes znamená něco jiného.
Člověk si s tím často poradí. Zná souvislosti, historii i omezení jednotlivých systémů. AI je nezná, pokud je nedostane do svého informačního základu.
A právě tady vzniká rozdíl mezi působivým demem a použitelným podnikovým řešením.
Při návrhu AI proto nestačí vybrat model, připojit několik zdrojů a postavit nad nimi uživatelské rozhraní. Je potřeba vyřešit vrstvu mezi daty a AI: jak informace získat, jak jim rozumět, jak identifikovat entity a vztahy, jak zachovat jejich souvislosti, původ a oprávnění a jak zajistit, aby bylo možné výsledek dohledat zpět ke zdroji.
To není přípravná práce před skutečnou AI. To je součást samotné AI architektury.
Staré garbage in, garbage out tak pořád platí. Jen s jedním nepříjemným upgradem: dnešní garbage out je často napsané bezchybnou češtinou a působí velmi přesvědčivě.Pro CIO je tu ještě jeden důležitý rozměr. Modely se budou měnit. Stejně tak dodavatelé, rozhraní i ceny. Není proto rozumné stavět podnikovou AI architekturu tak, aby byla pevně svázaná s jedním modelem nebo jedním technologickým dodavatelem.
Naopak dává smysl vytvořit stabilní informační vrstvu, nad kterou lze modely měnit podle potřeby.
Vaše smlouvy, zákazníci, transakce, dokumenty a vztahy mezi nimi totiž nezmizí jen proto, že příští rok bude nejlepší jiný model.
A s rostoucím významem AI roste také požadavek na dohledatelnost. Jakmile výstup ovlivňuje rozhodování, nestačí, že zní plausibilně. Musíte vědět, z čeho vznikl. Pokud model zkombinuje tisíce dokumentů, několik databází a stovky odvozených vztahů, musí být možné vrátit se ke zdrojovým informacím.
Jinak nemáte analytický systém. Máte velmi kultivovaný generátor tvrzení.
A právě zde má své místo Tovek.
Tovek vytváří informační vrstvu nad heterogenními zdroji. Dokáže jejich obsah analyzovat, identifikovat entity a vztahy, pracovat s jejich souvislostmi a zachovat vazbu zpět ke zdrojovým informacím.
Může fungovat jako samostatné analytické prostředí nebo jako vrstva pro další aplikace a AI nástroje.
Proto Toveku více než AI-powered sedí Powering AI.
Nejde o další chatbot připojený k datům. Jde o informační základ, nad nímž mohou bezpečně fungovat chatbot, agent, analytika nebo aplikace, kterou si dnes ještě neumíme představit.
Pro CIO je to v konečném důsledku otázka architektury a investice. Nestavět pokaždé AI znovu od dat nahoru, ale vytvořit základ, který přežije změnu modelu, aplikace i dodavatele.
Protože secí stroj dnes chodí skoro každému.
Rozdíl je v tom, co po něm vyroste.

 PŘEDPLATNÉ
 ČLÁNKY DO MAILU